トップ > 関数 > Googleスプレッドシート専用 > IMPORTXML
Webページの見出しや価格を、表に自動で取り込む
IMPORTXML(インポートエックスエムエル)関数
Webページに載っている見出しや価格を、手でコピーして表に貼る作業は、ページが更新されるたびにやり直しです。IMPORTXML は、ページのアドレスと XPath(ページの中の場所の指定)を書くと、その部分の文字を取り込む関数です。
✅ これができます:公開ページの見出しや価格などの文字が、数式だけで表に取り込めるようになります
完成形(実行前 → 実行後)
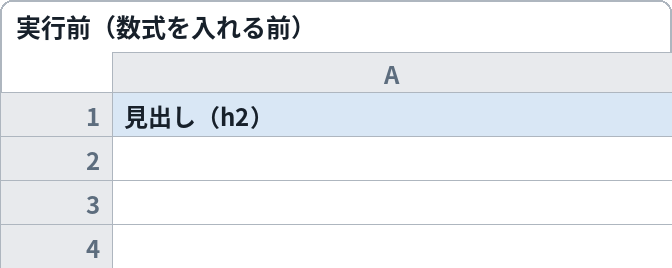
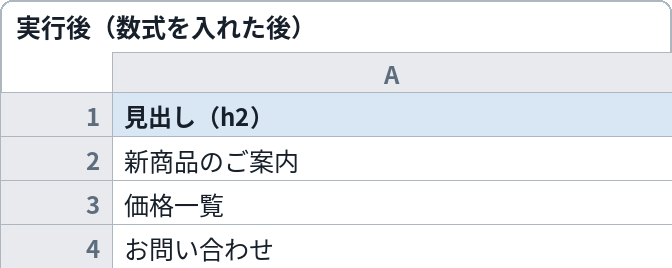
数式を入れる前(左)は空欄。入れた後(右)は、対象ページの見出しの文字が一覧で取り込まれます。ページ側が更新されれば、取り込み結果も変わります
これをコピペすれば動きます
ページの見出し(h2)を抜き出す数式(A1 に入れる。結果は下へ広がる)
=IMPORTXML("https://example.com/", "//h2")価格の部分だけを抜き出す版(class が price の span)
=IMPORTXML("https://example.com/", "//span[@class='price']")変えるのはここだけ
| 番号 | 変える場所 | 意味 | 書き方・例 |
|---|---|---|---|
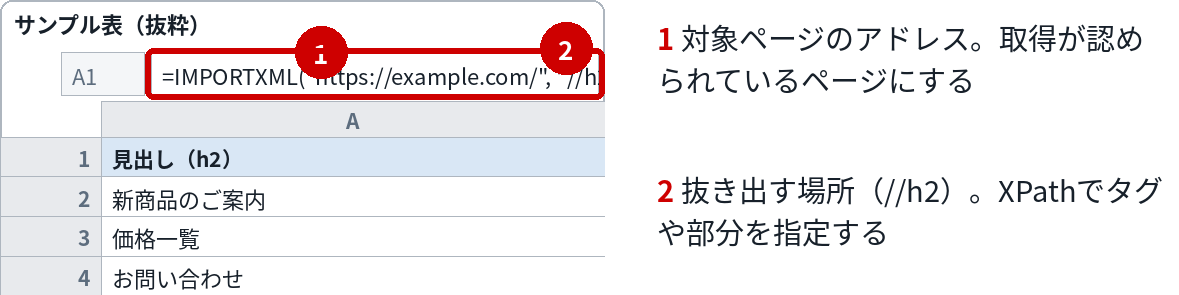
| 1 | 対象ページのアドレスhttps://example.com/ | 取り込みたい公開ページの URL | 自分の管理するページや、利用規約で取得が認められているページの URL に変える |
| 2 | 抜き出す場所(XPath)//h2 | ページの中で抜きたい部分の指定。//h2 は「h2 見出しすべて」という意味 | タイトルなら //title、リンク先なら //a/@href のように変える |
組み込み手順
- 取り込みたいページが、利用規約で自動取得を禁じていないか先に確認します
- A1 に1つ目の数式を貼り付けます。見出しの文字が下方向に並びます
- 価格など特定の部分が欲しいときは、2つ目の数式のように XPath を変えます
- 取得できない場合は、ページの作り(JavaScript で表示されるページなど)が原因のことが多いため、無理に繰り返さず対象を見直します
- 自分の用途で使うときは、「変えるのはここだけ」の1と2を差し替えます
このページのサンプルは、https://example.com/ の h2 見出しを取り込む例です。見出しが3つあるページなら、結果は3行に並びます。
Excelとスプレッドシートの違い
Excelにはこの関数自体がありません。近い方法として「データ」タブの「Webから」で表を取り込む方法はありますが、XPath で場所を指定する IMPORTXML とは使い方が異なります。
カスタマイズ例
リンクの URL も一緒に取りたい
XPath を //a/@href にすると、ページ内のリンク先 URL の一覧が取れます。見出しと並べて取り込むと、見出しとリンク先の対応表が作れます。
特定の id の中だけを抜きたい
XPath を //div[@id='main']//h2 のように書くと、id が main の範囲の中の見出しだけに絞れます。
取り込んだ文字を整えたい
余分な空白は TRIM や REGEXREPLACE で整えます。取り込みと整形を分けると、数式が読みやすくなります。
つまずきどころ
- 対象サイトの利用規約を先に確認すること。自動取得(スクレイピング)を禁止しているサイトでは使わないでください
- スプレッドシートは自動で再計算されるため、知らないうちに何度もアクセスしに行きます。大量・頻繁な取得には向かないため、件数を絞って使ってください
- 取得できないページもあります。JavaScriptで描画されるページ、ログインが必要なページ、アクセスを拒否されるページでは結果が返りません
- #N/A と出る → XPath がページの構造と合っていないケースです。タグ名や class 名を確認してください
関連する関数・レシピ
次はこれ:IMPORTHTML(Webページの表やリストを取り込む)
ページの中の「表」や「リスト」が目的なら、IMPORTHTML のほうが短く書けます
よくある質問
Q. XPath はどうやって調べる?
A. ブラウザの開発者ツールでページの要素を確認し、タグ名や class 名を手がかりに書きます。まずは //h2 のような単純な指定から試すのが分かりやすいです。
Q. 更新は自動でされる?
A. スプレッドシートの再計算のタイミングで再取得されます。そのため、短い間隔で何度も開くと、アクセス回数も増えます。
Q. 自分のサイトの確認にも使える?
A. 使えます。自分のページの見出し一覧を取り込んで、見出しの抜けや重なりを確認する用途に向いています。